Warum mit Claude oder Codex gebaute Projekte vor dem Launch ins Stocken geraten
Claude Code und Codex bringen eine Idee in wenigen Tagen zum funktionierenden Prototyp, doch viele dieser Projekte stocken vor dem Launch. Erfahren Sie, warum die letzte Etappe schwieriger wird und wie Sie eine halb fertige Codebasis fertigstellen.
7 Min. Lesezeit


Inhalt
Sie öffnen Claude Code an einem Freitagabend mit einer Produktidee. Am Sonntag gibt es einen Login-Bildschirm, ein Dashboard und eine Datenbank, die echte Datensätze speichert. Drei Wochen später ist das Projekt immer noch in einem Terminal-Tab geöffnet, und jede neue Session scheint etwas kaputtzumachen, das in der Woche davor noch funktioniert hat.
Dieses Muster ist so verbreitet, dass es eine wiedererkennbare Form hat. KI-Coding-Agenten wie Claude Code von Anthropic und Codex von OpenAI sind gut darin, die erste Version eines Produkts zu erstellen. Die Arbeit danach, also aus einer Demo etwas zu machen, auf das sich Kunden verlassen können, ist der Punkt, an dem viele Projekte langsamer werden und stehen bleiben.
Auch Entwickler spüren das. In der Stack Overflow 2025 Developer Survey gaben 84 % der Befragten an, KI-Tools zu nutzen oder deren Nutzung zu planen. Ihr häufigster Frust, genannt von 66 %, waren „KI-Lösungen, die fast richtig sind, aber eben nicht ganz“, und 45 % sagten, dass das Debuggen von KI-generiertem Code mehr Zeit kostet.
Dieser Artikel zeigt, warum mit Claude oder Codex begonnene Projekte ins Stocken geraten, welche Teile eines Produkts typischerweise unfertig bleiben und wie Sie ein halb fertiges Projekt zum Launch bringen, mit oder ohne Unterstützung von außen.
Warum bleiben mit Claude oder Codex begonnene Projekte auf halber Strecke stehen?
Ein Projekt stockt in der Regel dann, wenn jede Änderung mehr kostet, als sie an Fortschritt bringt. In den ersten Tagen arbeitet der Agent in einem leeren Ordner, sodass jede Anfrage etwas Sichtbares hinzufügt. Ein paar Wochen später trifft jede Anfrage auf bereits vorhandenen Code, und jede Änderung hat mehr Möglichkeiten, etwas anderes kaputtzumachen.
Auch die Geschwindigkeit ist schwerer einzuschätzen, als es scheint. Eine randomisierte Studie von METR aus dem Jahr 2025 ergab, dass erfahrene Open-Source-Entwickler 19 % länger für ihre Aufgaben brauchten, wenn sie KI-Tools (Cursor mit Claude 3.5 und 3.7 Sonnet) verwenden durften, während sie glaubten, die Tools hätten sie um 20 % schneller gemacht. Die Studie hat Tools vom Anfang des Jahres 2025 an großen, ausgereiften Codebasen gemessen, und die Modelle haben sich seitdem verbessert. Die Lücke zwischen gefühltem und tatsächlichem Arbeitstempo sollten Sie trotzdem im Blick behalten, während ein Projekt wächst.
Der Agent vergisst, was letzte Woche entschieden wurde
Claude Code und Codex arbeiten innerhalb eines Kontextfensters, das alles enthält, was der Agent während einer Session über Ihr Projekt weiß. Die Claude-Code-Leitlinien von Anthropic weisen darauf hin, dass die Leistung nachlässt, je voller der Kontext wird, und dass der Agent beginnen kann, frühere Anweisungen zu vergessen. Wenn eine neue Session startet, sind frühere Entscheidungen weg, sofern sie niemand ins Repository geschrieben hat.
Das Ergebnis ist ein schleichendes Auseinanderdriften. Eine Session speichert Datumsangaben als Text, die nächste als Zeitstempel. Ein Bildschirm nutzt die gemeinsame Button-Komponente, ein anderer bekommt eine neue. Jede Entscheidung ist für sich genommen nachvollziehbar, zusammen machen sie die Codebasis schwerer veränderbar.
Fast richtiger Code häuft sich an
Fast richtiger Code übersteht ein schnelles Durchklicken. Die Lücke zeigt sich später als Sonderfall: eine leere Liste, ein langsames Netzwerk, ein Nutzer, der sich zweimal mit derselben E-Mail-Adresse registriert.
Ohne Tests hat der Agent keine Möglichkeit, seine eigene Arbeit zu prüfen, sodass die Korrektur eines Sonderfalls stillschweigend einen anderen kaputtmachen kann. Die Leitlinien von Anthropic sagen es ganz offen: „Claude hört auf, wenn die Arbeit fertig aussieht.“
Niemand hat aufgeschrieben, was das Produkt können muss
Viele mit KI begonnene Projekte starten mit einem einzigen Prompt und wachsen Feature für Feature. Es gibt keine schriftliche Beschreibung der Nutzer, der zentralen Abläufe oder dessen, was „fertig“ für das erste Release bedeutet. Der Agent füllt diese Lücken mit plausiblen Annahmen, und das Team merkt erst beim Testen der App, welche Annahmen falsch waren.
Welche Teile eines mit KI gebauten Projekts sind meist unfertig?
Bei den mit KI gebauten Projekten, die wir übernehmen sollen, sind die sichtbaren Bildschirme meist in gutem Zustand. Der Großteil der unfertigen Arbeit liegt darunter.
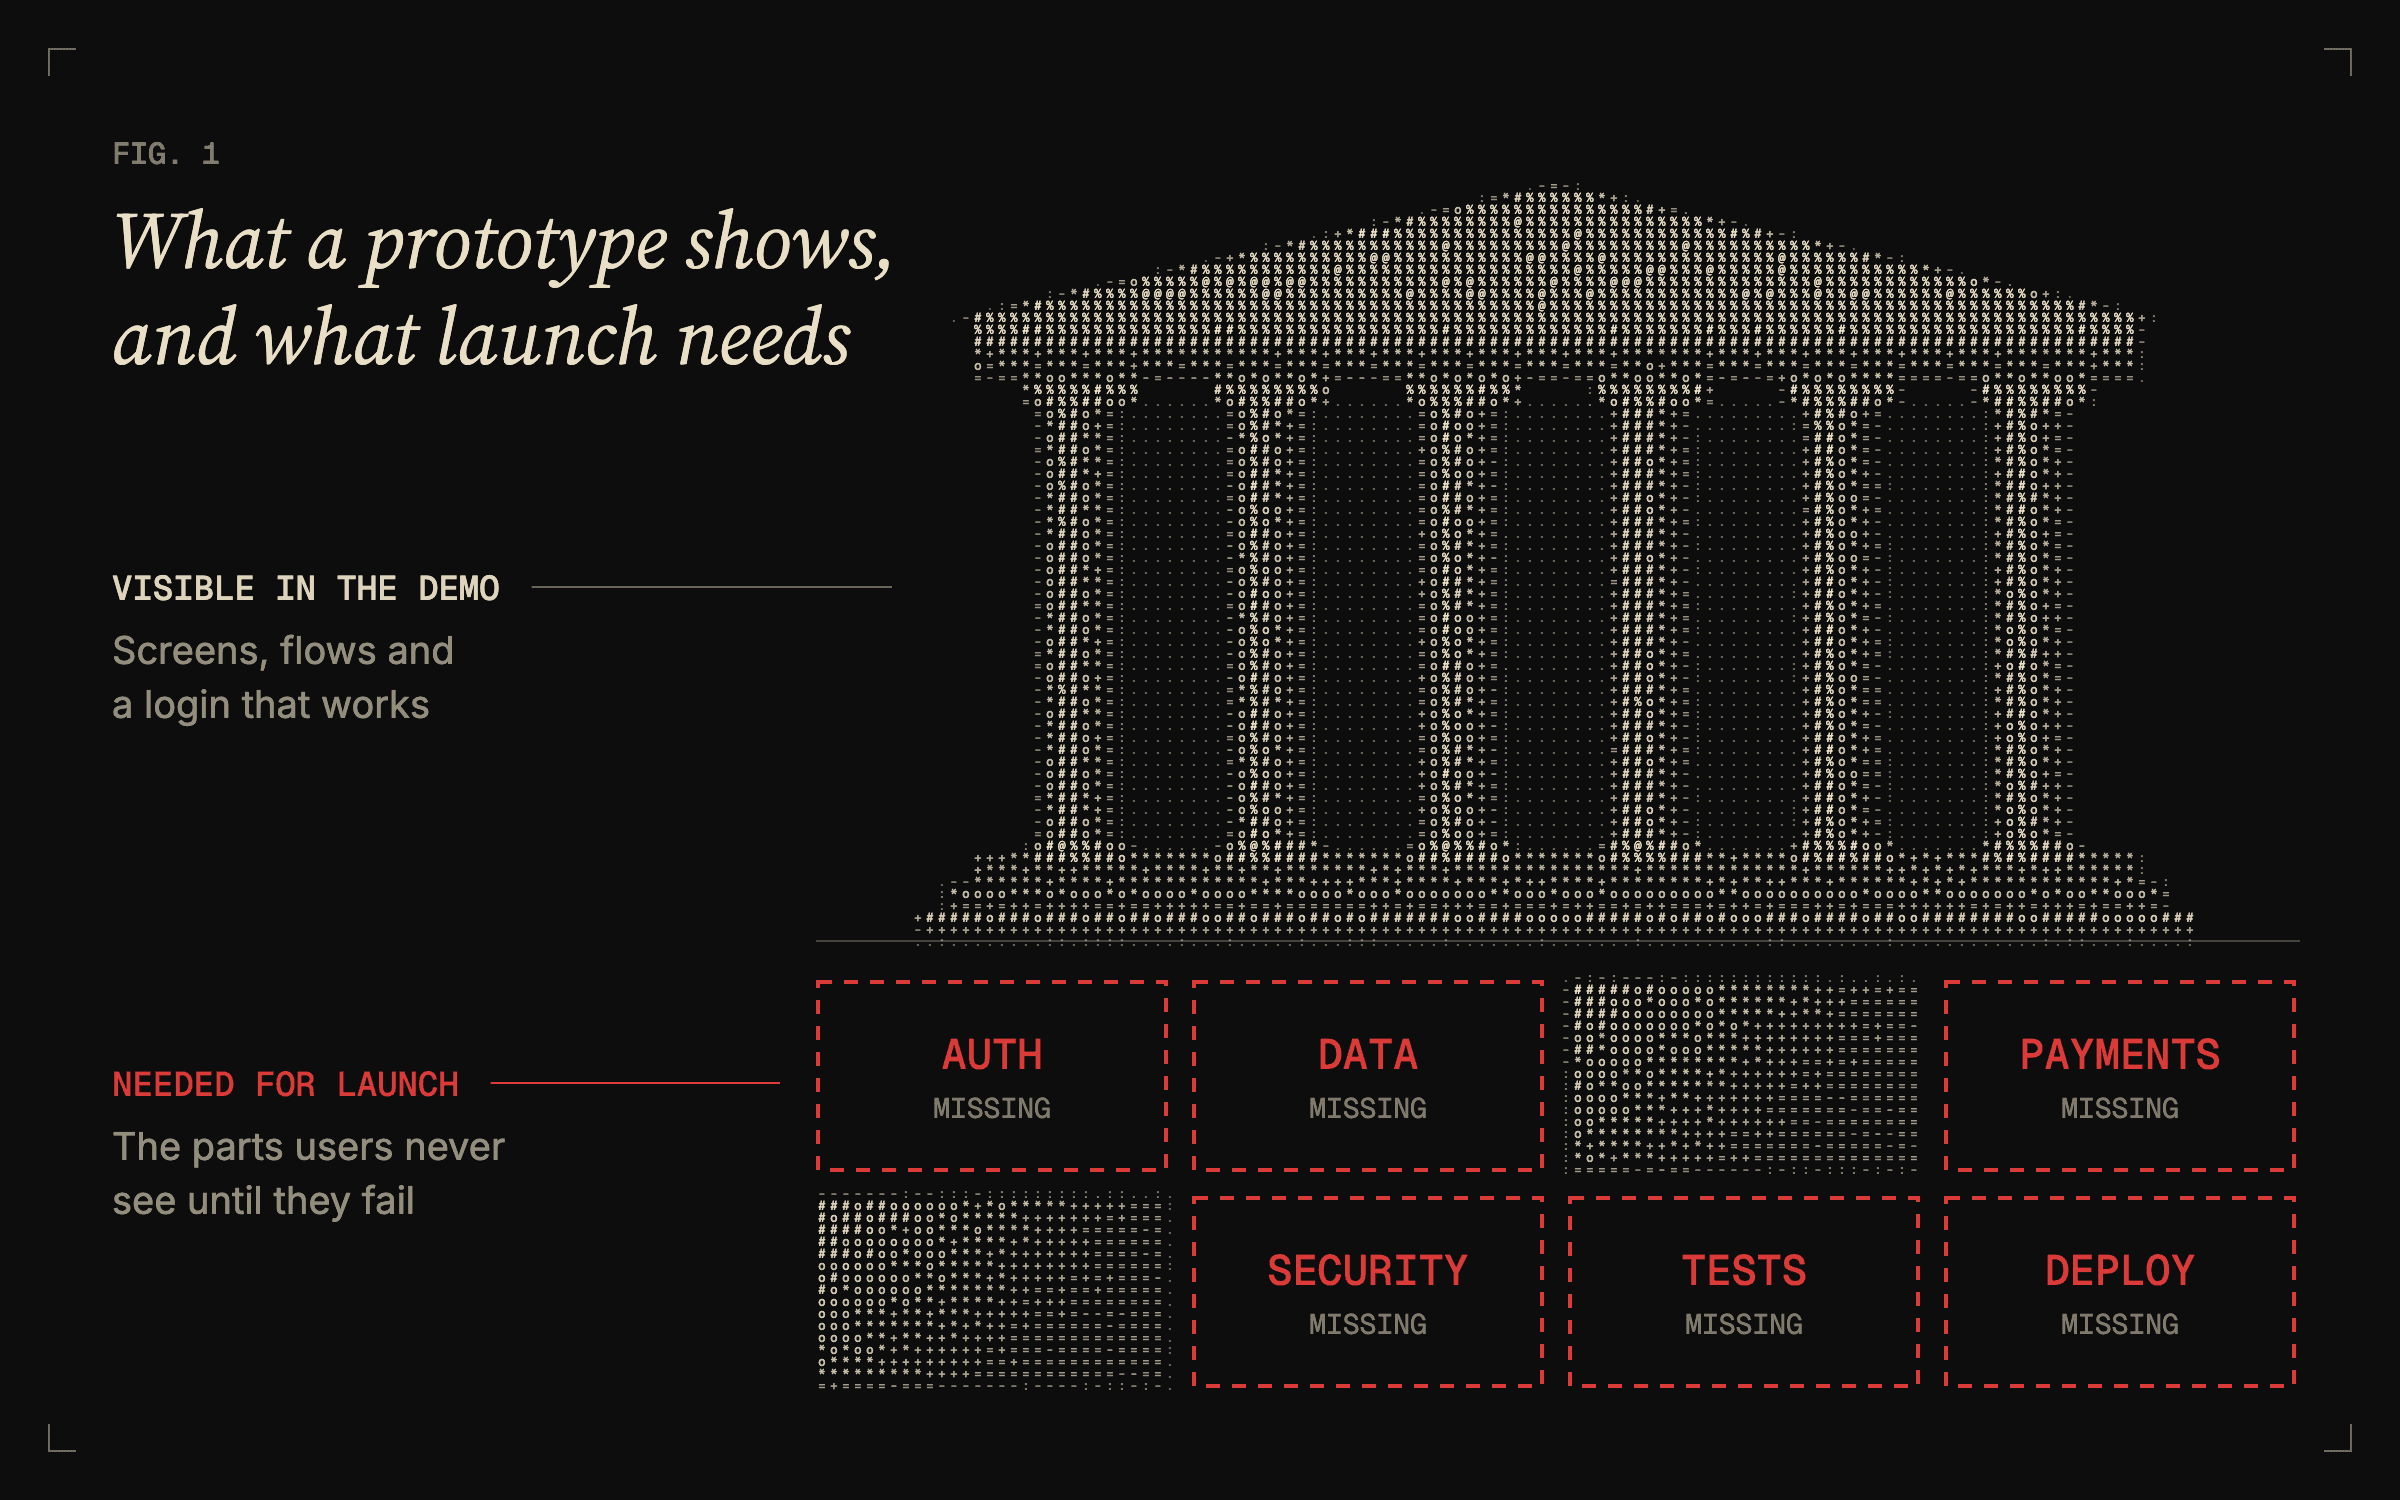
Authentifizierung und Berechtigungen. Registrierung und Login funktionieren, aber Rollen, das Zurücksetzen von Passwörtern, das Ablaufen von Sessions und die Regeln dafür, was jeder Nutzer sehen darf, fehlen oft.
Datenmodell und Migrationen. Das Datenbankschema hat sich während des Prototypings viele Male geändert, und es gibt keinen sicheren Weg, es erneut zu ändern, sobald echte Nutzer Daten darin haben.
Zahlungen und Integrationen. Webhooks, Wiederholungsversuche und Zustände für fehlgeschlagene Zahlungen tauchen in einer Demo selten auf, entscheiden aber darüber, ob Ihre Datensätze und Ihr Zahlungsanbieter synchron bleiben.
Fehlerbehandlung und leere Zustände. Der Hauptpfad funktioniert. Bei langsamen Verbindungen, fehlgeschlagenen Anfragen und neuen Nutzern ohne Daten erscheinen oft leere Bildschirme oder rohe Fehlermeldungen.
Sicherheit. Der GenAI Code Security Report 2025 von Veracode ergab, dass 45 % der KI-generierten Codebeispiele Sicherheitstests nicht bestanden und Schwachstellen aus den OWASP Top 10 einführten. Secrets im Client-Code, fehlende Eingabevalidierung und offene Datenbankregeln kommen häufig vor.
Deployment und Monitoring. Die App läuft auf einem Laptop. Für den Produktivbetrieb braucht es getrennte Umgebungen, Backups, Logs und eine Möglichkeit zu erkennen, wenn etwas ausfällt.
Tests. Ohne automatisierte Tests muss jede Änderung von Hand geprüft werden, und der Agent kann seine eigene Arbeit nicht verifizieren.
Keines dieser Probleme ist ungewöhnlich. Es ist die gewöhnliche Arbeit, die einen Prototyp von einem Produkt unterscheidet, und sie lässt sich nur schwer in einem einzigen Prompt beschreiben.
Neu anfangen oder fertigstellen, was Sie haben?
Wenn ein Projekt stockt, ist es verlockend, eine neue Session in einem neuen Ordner zu öffnen. Ein leeres Projekt fühlt sich wieder schnell an, genau wie das erste.
Ein Neustart beseitigt die Ursache selten. Wenn Anforderungen, Entscheidungen und Prüfungen beim ersten Mal gefehlt haben, bleibt die zweite Version meist an derselben Stelle stecken. Ein Rewrite wirft außerdem die Teile weg, die bereits funktionieren, und das ist bei den meisten mit KI begonnenen Projekten ein großer Teil des Codes.
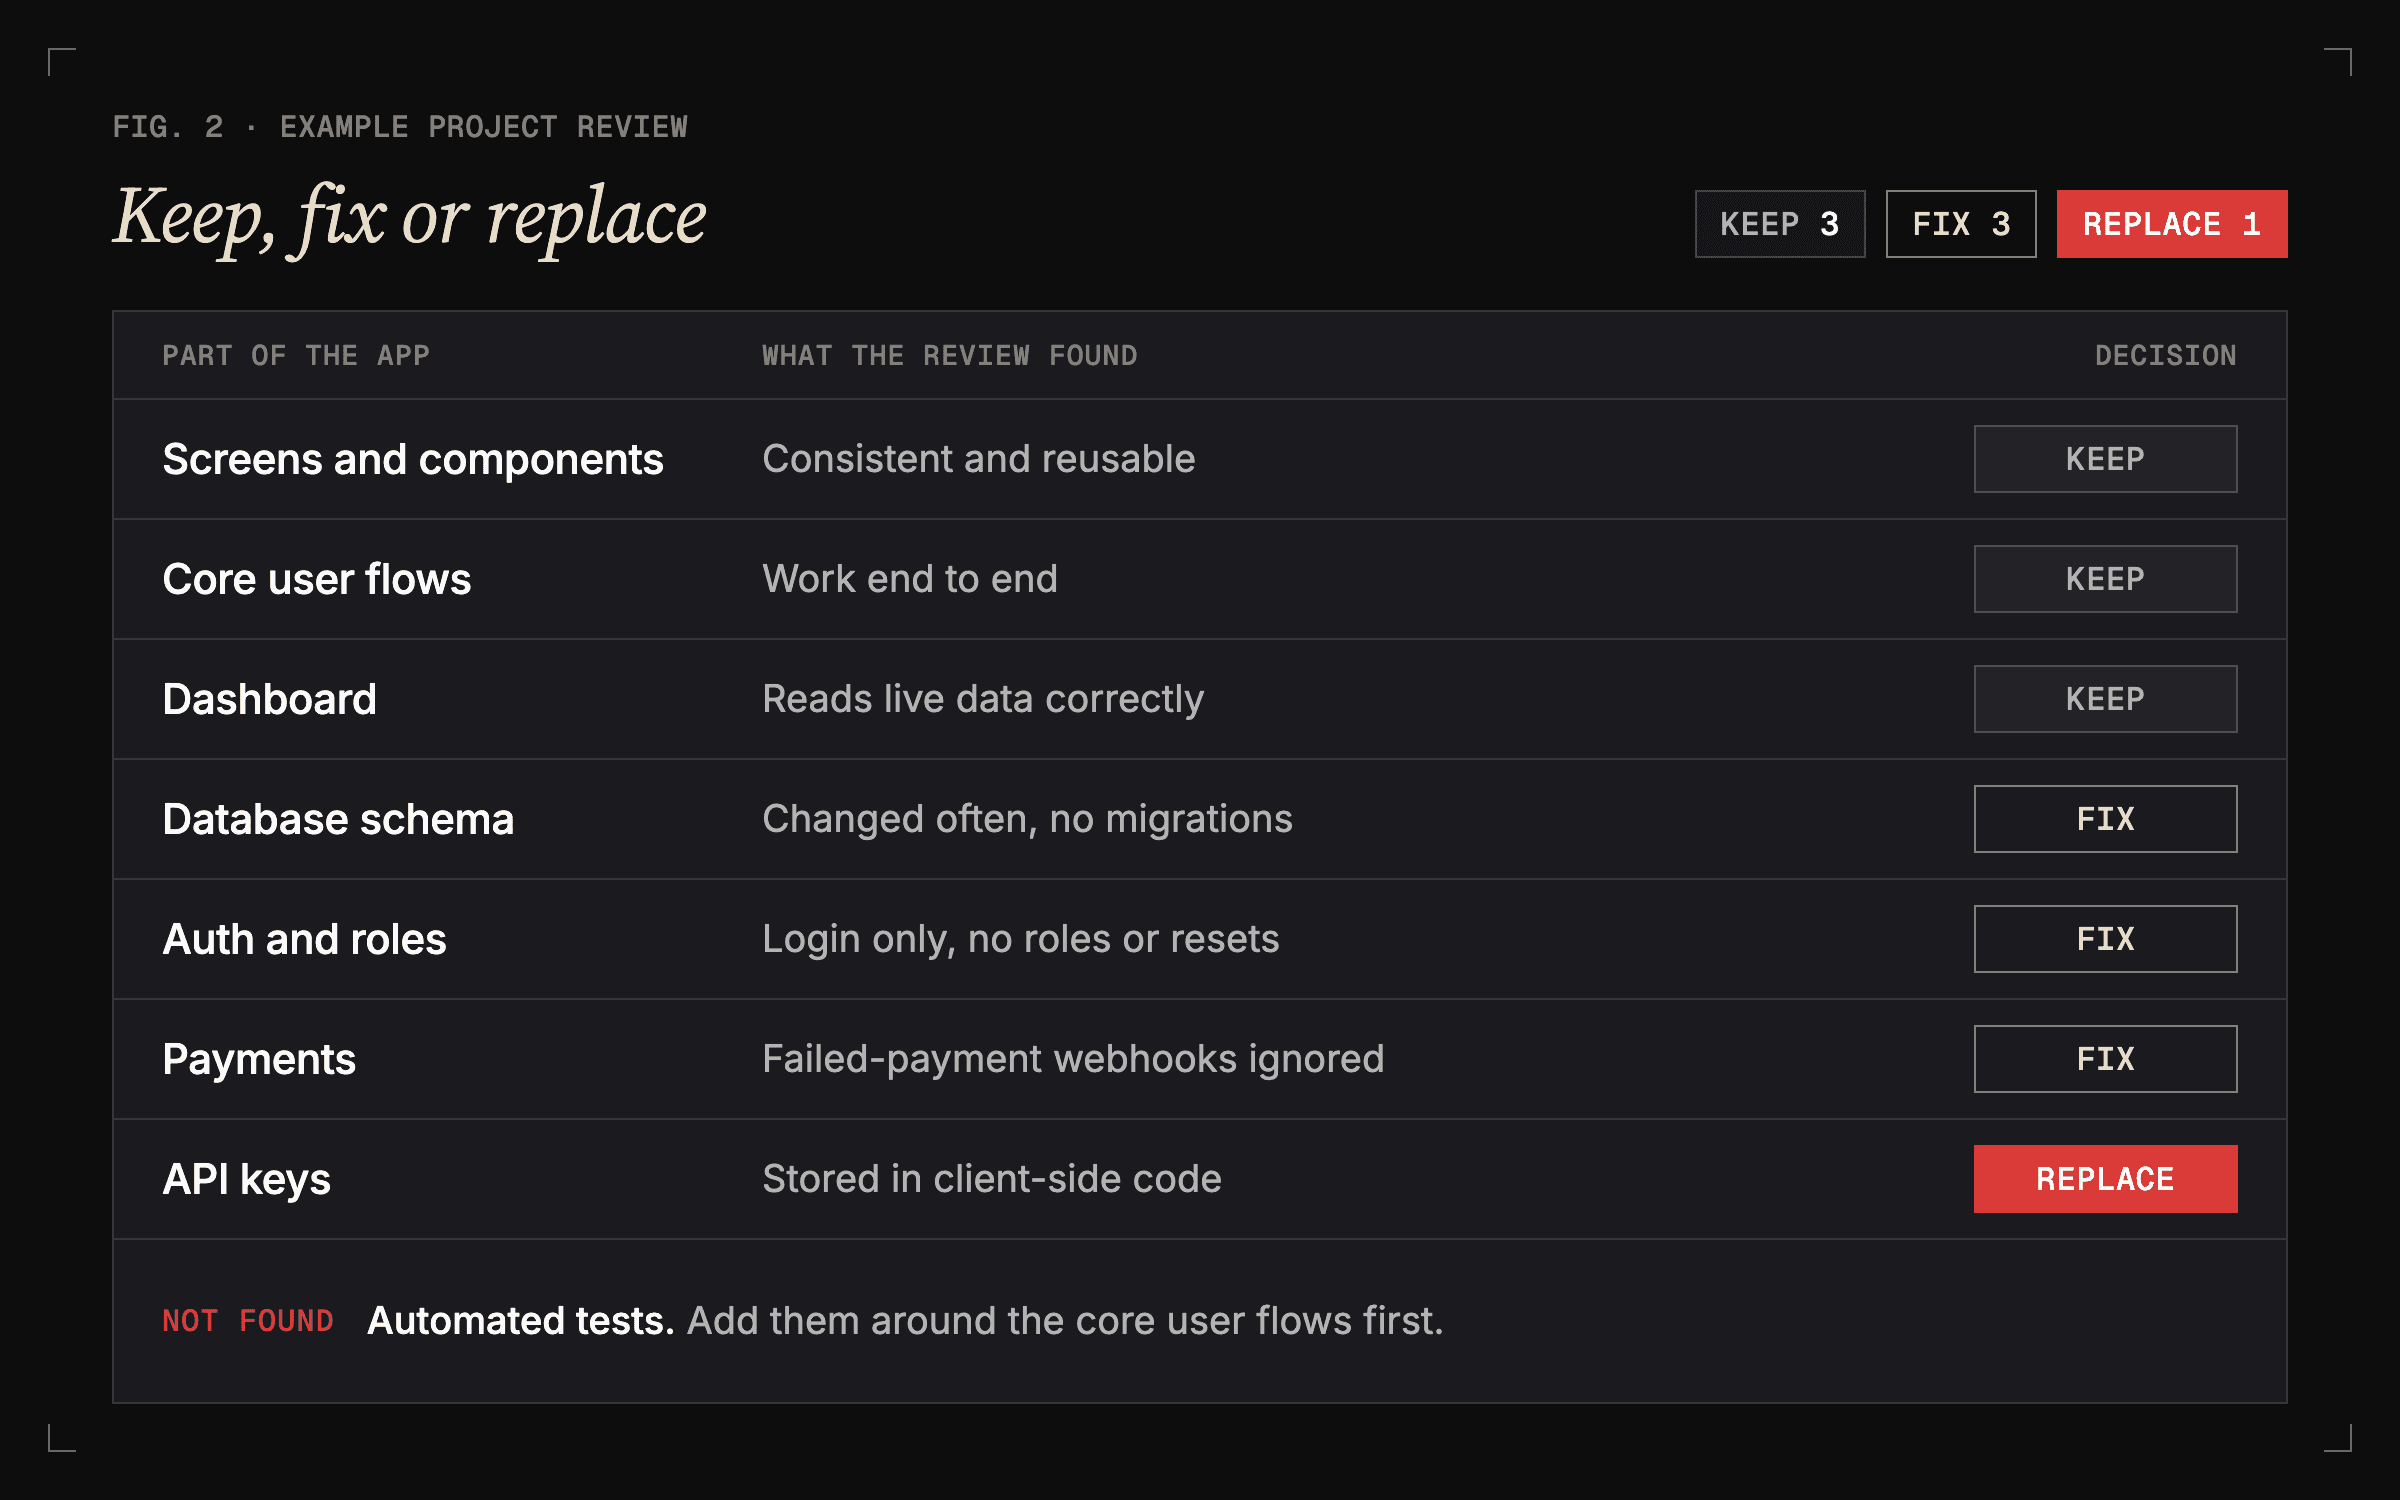
Ein besserer erster Schritt ist herauszufinden, was Sie haben. Gehen Sie die Codebasis durch und ordnen Sie jeden Teil einer von drei Gruppen zu: Er funktioniert und kann bleiben, er funktioniert, muss aber vor dem Launch korrigiert werden, oder er muss ersetzt werden. Unserer Erfahrung nach ist die letzte Gruppe meist die kürzeste.
Wie stellen Sie ein Projekt fertig, das Sie mit einem KI-Coding-Agenten begonnen haben?
Die folgenden Schritte funktionieren unabhängig davon, ob Sie Claude Code oder Codex weiterhin selbst nutzen oder ein Team hinzuziehen. Jeder Schritt erleichtert Menschen wie Agenten den nächsten.
Schreiben Sie auf, was das erste Release können muss
Listen Sie die Nutzer auf, die drei bis fünf Abläufe, die sie abschließen können müssen, und was für den Launch außerhalb des Umfangs liegt. Dieses Dokument wird zur Referenz für jede folgende Session. Für größere Features empfiehlt Anthropic, sich von Claude interviewen zu lassen und vor Beginn der Implementierung eine vollständige Spezifikation in eine Datei schreiben zu lassen.
Geben Sie dem Agenten ein Gedächtnis, das er lesen kann
Entscheidungen, die nur in einem Chatverlauf stehen, verschwinden, wenn die Session endet. Claude Code liest zu Beginn jeder Session eine CLAUDE.md-Datei, und Codex liest AGENTS.md-Dateien, bevor es mit der Arbeit beginnt. Nutzen Sie sie für die Regeln, die für jede Änderung gelten: wie die App gestartet wird, welchen Mustern zu folgen ist, welche Ordner unangetastet bleiben und wie getestet wird. Halten Sie sie kurz, denn bei langen Anweisungsdateien übersieht der Agent leichter die Regeln, auf die es ankommt.
Ergänzen Sie Tests für die Abläufe, die bereits funktionieren
Bevor Sie irgendetwas anderes ändern, schreiben Sie Tests für die zentralen Abläufe, die heute funktionieren. Tests schützen, was Sie bereits haben, und sie geben dem Agenten ein Bestanden-oder-Nicht-bestanden-Signal, das er ohne Sie ausführen kann. Anthropic beschreibt eine Prüfung, die der Agent selbst ausführen kann, als „den Unterschied zwischen einer Session, die Sie beobachten, und einer, bei der Sie weggehen können“.
Arbeiten Sie in kleinen, überprüfbaren Änderungen
Bitten Sie jeweils um eine Änderung, lesen Sie den Diff, führen Sie die Tests aus und committen Sie. Starten Sie zwischen voneinander unabhängigen Aufgaben eine neue Session, damit der Kontext nicht mit alten Versuchen überfüllt ist. Wenn der Agent zweimal an derselben Korrektur scheitert, hören Sie auf, ihn in dieser Session zu korrigieren, und formulieren Sie die Anfrage mit dem Gelernten neu.
Schließen Sie die Lücken für den Produktivbetrieb nach Risiko
Arbeiten Sie die Liste der unfertigen Punkte von oben ab, beginnend mit denen, die Nutzerdaten oder Zahlungen gefährden: Sicherheit, Authentifizierung, Datenmigrationen und Zahlungsabwicklung. Visueller Feinschliff und neue Features können warten, bis das Produkt sicher genug für echte Nutzer ist.
Holen Sie sich vor dem Launch ein zweites Paar Augen
Manche Probleme sind von innerhalb des Projekts schwer zu erkennen. Ein Entwickler, der den Code nicht geschrieben hat, oder eine neue Agent-Session, die den Diff reviewen soll, findet Probleme, die die ursprüngliche Session wegerklärt. Wenn das Projekt Umsätze oder Kundendaten verarbeitet oder ein Launch-Termin feststeht, kostet ein Review durch ein erfahrenes Team meist weniger als ein zweiter Rewrite.
Fazit
Claude Code und Codex haben die erste Version eines Produkts deutlich günstiger gemacht. Die Arbeit danach ist aber immer noch da: entscheiden, was das Produkt können muss, Entscheidungen über Sessions hinweg konsistent halten und das Gebaute testen, absichern und deployen.
Ein ins Stocken geratenes Projekt ist oft näher am Launch, als es sich anfühlt. Die Bildschirme und Abläufe, die bereits funktionieren, sind echter Fortschritt. Was meist fehlt, ist eine klare Liste der offenen Punkte, eine Möglichkeit, jede Änderung zu prüfen, und die Arbeit für den Produktivbetrieb, die Prototypen auslassen.
Vizio.ai hilft Teams, Produkte zu übernehmen, die mit KI-Coding-Tools oder App-Buildern begonnen wurden. Wir gehen den Code durch, entscheiden, was bleiben kann und was korrigiert werden muss, und bringen das Produkt in den Produktivbetrieb, ohne die Teile neu zu bauen, die bereits funktionieren.
Sie haben ein halb fertiges Produkt? Erzählen Sie uns, wo es heute steht.
FAQs.
Weiterlesen

Attribution That Survives Your Tool Stack: Keeping UTMs From Ad to Booking to CRM

Clean Your CRM Data Before You Add AI: Dedupe, Grain and Ownership

Semantic Layer First: Getting Your BI Ready for AI Agents

How F&B CMOs Use Generative AI In Business For Location Decisions

How Real Estate Firms Use Business Analytics For City Parks To Drive Value

Data Storytelling and Visualization

When Does a Business Actually Need Digital Transformation?

Analytics for Product Recommendations

Data Analyst vs. Data Quality Analyst

The Best NoSQL Analytics Tools 2024
Mehr lesen.

Your First 30 Days With a Product Studio: What Happens Week by Week
The first 30 days with a product studio: week one sets access and goals, week two tests the riskiest assumption, weeks three and four ship a first slice.

What Does an AI Agent Cost to Run? Tokens, Tools and the Hidden Line Items
An AI agent's running cost is model tokens across every step, plus retries, tool and search fees, hosting, monitoring and human review. Budget per task, not per token.

AI Lead Scoring in Your CRM: Start With the Rules You Already Trust
Add AI lead scoring by writing down the rules sales already trusts, cleaning CRM data, then testing the AI score against those rules before reps use it.